
Cos’è SAX Encoding?
Il Symbolic Aggregate approXimation (SAX) encoding è un metodo per semplificare le serie storiche. E’ stato inventato da Eamonn Keogh e Jessica Lin nel 2002.
SAX è un modo di trasformare una serie temporale in una sequenza di simboli. L’idea di base è che ogni simbolo rappresenta un intervallo.
Questa tecnica permette di condurre una dimensionality reduction sulle serie storiche quindi possiamo considerarlo un metodo non supervisionato.
Bisogna evidenziare che il SAX è una tecnica molto robusta ai valori mancanti e quindi utilizzabile quando si è in presenza di serie di lunghezza diversa.
Per rafforzare l’ultima considerazione vi invito a leggere un articolo di KDNuggets dove viene utilizzato SAX Encoding per trovare anomalie tra le stagioni di varie squadre di baseball. Non tutte le stagioni hanno lo stesso numero di match e alcuni dati sono mancanti.
Dataset
Visto il momento in cui viene scritto questo articolo proverò a utilizzare il SAX Encoding sui dati della protezione civile cercare i pattern tra le serie regionali dei contagi da Covid-19.
- L’orizzonte temporale và dal 24/02/2020 al 21/04/2020.
- La distribuzione geografica è per Regione anche se il Trentino - Alto Adige è diviso nelle due province autonome.
La colonna che useremo sarà totale_positivi.
Riporto direttamente dal readme del repository ufficiale della protezione civile
Totale attualmente positivi (ospedalizzati + isolamento domiciliare)
ATTENZIONE!!! IMPORTANTE.
Naturalmente non sono un medico/epidemiologo/virologo/… quindi il mio interesse è solo trovare un dataset che mi permettesse di spiegare come funziona l’algoritmo, non trarrò nessuna conclusione dai dati.
| data |
denominazione_regione |
totale_positivi |
| 2020-02-24T18:00:00 |
Abruzzo |
0 |
| 2020-02-24T18:00:00 |
Basilicata |
0 |
| … |
… |
… |
| 2020-04-21T17:00:00 |
Valle d’Aosta |
522 |
| 2020-04-21T17:00:00 |
Veneto |
10077 |

Tutto il codice di questo articolo è disponibile su un notebook Google Colab. Il dataset aggiornato può essere scaricato qui.
Come funziona l’algoritmo
Step 1: Standardizzare la serie
Per applicare questa tecnica bisogna avere la serie storica sulla riga e ad ogni colonna coinciderà uno step temporale.
| Regione |
1 |
2 |
… |
57 |
| Abruzzo |
0 |
0 |
… |
2067 |
| Basilicata |
0 |
… |
… |
245 |
| … |
… |
… |
… |
… |
| Veneto |
32 |
… |
… |
10077 |
Le serie devono essere standardizzate così da avere la stessa scala.
\(Z = \frac{x - \mu}{\sigma}\)
Questa tecnica non si basa solo sui volumi ma anche sugli andamenti. In questo caso in numeri assoluti la Lombardia è molto distante dalle altre regioni, ma lo sarà anche come andamento? Questa è la domanda a cui ci aiuterà a rispondere SAX Encoding.
tot_pos_pivot = totale_positivi.pivot(index="data", columns="denominazione_regione", values="totale_positivi").reset_index()

df_stand = ((tot_pos_pivot.drop("data", axis=1) - tot_pos_pivot.mean())/tot_pos_pivot.std()).T
Ora abbiamo la nostra matrice con sull’indice il nome della serie, ovvero la regione e sulle colonne il periodo da 0 a 57.
| Regione |
1 |
2 |
… |
57 |
| Abruzzo |
-1.067762 |
-1.067762 |
… |
1.699956 |
| Basilicata |
-1.063952 |
… |
… |
1.041431 |
| … |
… |
… |
… |
… |
| Veneto |
-1.244880 |
… |
… |
10766 |
Step 2: Piecewise Aggregate Approximation
Come accennato inzialmente questo metodo riduce la dimensionalità della serie e lo fa proprio con la P.A.A., l’idea alla base è “riassumere” la sequenza in una serie di segmenti che ne riducano la lunghezza ma ne rappresentino ugualmente l’informazione.
Data una time series \(Y =\) [\(Y_{1}\), \(Y_{2}\), …, \(Y_{n}\)] che può essere ridotta in una sequenza \(X =\) [\(X_{1}\), \(X_{2}\), …, \(X_{m}\)] con \(m \leq n\) l’equazione che sintetizza gli elementi della time series originale per adattarli alla nuova dimensione è la seguente:
\(\bar{X}_i = \frac{m}{n} \cdot \sum_{j=n/N(i-1) + 1}^{(n/M)\cdot i} x_j\)
Quindi la media per ogni finestra temporale che costituirà la nuova sequenza. Si possono notare subito due casi particolari:
- m = n, la nuova sequenza è identica alla serie storica originale
- m = 1, la nuova sequenza ha un solo valore equivalente alla media dei valori dell’intera time series
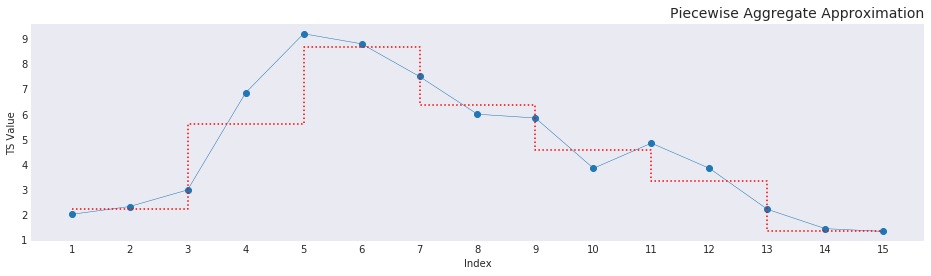
Per applicare la P.A.A. avremo bisogno di scegliere la dimensione della finestra temporale su cui calcolare l’informazione, questo influirà anche su quanti segmenti verranno utilizzati per ricostruire la serie storica.
In questo caso visto che i vari ragionamenti (sentiti in TV, ribadisco di non avere nessuna competenza) si basano su un tempo di 2 settimane imposterò il parametro (window) w=14.
Ridimensionata, ogni serie sarà una sequenza di lunghezza_serie/w periodi si prende la media del periodo come nuovo valore.
Attenzione: Bisogna impostare un controllo per non perdere informazioni, quindi se il nuovo numero di periodi non è un intero và sempre arrotondato per eccesso.
windows = 14

new_len = int(np.ceil((df_stand.shape[1]/windows)))

# Crea il nuovo dataFrame
df_PAA = pd.DataFrame(index = df_stand.index, columns = range(0, new_len))

# Calcola la media di ogni window
ind = 0
for i in range(0,df_stand.shape[1], windows):
    avg = df_stand.iloc[:,i:i+windows].mean(axis=1)
    df_PAA[ind] = avg.values
    ind +=1
| denominazione_regione |
0 |
1 |
2 |
3 |
4 |
| Abbruzzo |
-1.060876 |
-0.785615 |
0.352059 |
1.252060 |
1.696609 |
| Basilicata |
-1.055972 |
-0.846662 |
0.516006 |
1.239693 |
1.028541 |
| Calabria |
-1.088706 |
-0.797959 |
0.449874 |
1.246324 |
1.333274 |
Step 3: SAX
Preparato il dato si può lavorare a ciò che contraddistingue questa tecnica. Adesso il dato numerico verrà converito in stringa. La SAX String è derivazione del numero di livelli in cui si vuole suddividere la serie, ogni livello avrà un’etichetta, queste etichette verranno successivamente concatenate creando la SAX String. La scelta dei livelli influisce sul risultato quindi bisognerebbe sempre farsi affiancare da un esperto di dominio, il consiglio è quello di non creare troppi livelli altrimenti si avrebbe un’eterogeneità troppo alta e nono si troverebbero pattern.
I livelli possono essere fissati oppure calcolati ad ogni periodo, in questo caso si preferisce la seconda opzione.
Io non conoscendo il fenomeno supporrò 3 livelli [“A”, “B”, “C”] e suddividerò i valori:
- dal minimo fino al primo quartile
- tra primo e terzo quartile
- superiore al terzo quartile
In questi caso potremmo interpretarli come:
- pochi contagi, ottima situazione
- situazione nella media
- grave emergenza
Una volta definiti i livelli questi vengono concatenati in un’unica stringa detta appunto “SAX string”. Es. ABAAB
# Sto ridondando con i DataFrame creati ma è per mostrare i vari step, sorry.
binned = pd.DataFrame(index = df_PAA.index, columns = df_PAA.columns)

for j in range(0, df_PAA.shape[1]):
            bins = []
            bins.append(df_PAA[j].min()-.01)
            bins.append(df_PAA[j].quantile([0.25]).values[0])
            bins.append(df_PAA[j].quantile([0.75]).values[0])
            bins.append(df_PAA[j].max()+.01)
            labels = ["A", "B", "C"]
            binned[j] = pd.cut(df_PAA[j], bins, labels=labels)
binned['SAX_string'] = binned.apply(''.join, axis=1)
Il risultato finale del SAX Enconding lo si può vedere in tabella.
| denominazione_regione |
SAX_string |
| Abbruzzo |
CAABC |
| Basilicata |
CABBA |
| Calabria |
BABBB |
| … |
… |
Come utilizzare le SAX String?
Anomaly Detection
Il SAX Encoding può essere considerato un metodo non supervisionato di anomaly detection dove per anomalia (o outlier) non si intende la singola osservazione ma l’intera serie storica.
Possiamo calcolare la frequenza di ogni SAX String, impostato il limite che per noi determina un outlier etichettare come tale tutte le serie con frequenza della SAX String minore o uguale al bound.
Nell’immagine ho impostato come bound 1
In rosso abbiamo gli outlier, blu le sequenze con frequenza maggiore di 1, vediamo che quasi ogni regione ha un suo andamento, questo dovuto a diversi fattori (territorio, controlli, …)

Clustering
Sempre rimanendo nel campo dei modelli non supervisionati le SAX String possono essere utilizzate per il clustering.
Un’applicazione che mi viene in mente è il clustering gerarchico utilizzando come misura di similarità (o dissimilarità a seconda se agglomerativo o divisivo) la distanza di Levenshtein.
Classification
Passando ai metodi supervisionati, avendo già delle serie storiche etichettate, penso ad esempio a quelle sul consumo energetico che hanno anche una certa stagionalità, si potrebbe applicare il KNN alla sequenza per classificare le nuove serie.
Stream Data
Nel precedente paragrafo ho citato la stagionalità perchè in questo articolo non è stato trattato un tema di forte interesse come il dato in stream.
Con la diffusione dell’IoT le time series in stream sono un tema sempre più caldo sia per quanto riguarda l’immagazzinamento dei dati che per le analisi.
Nel caso di serie con stagionalità, o forti componenti cicliche, oltre alla finestra temporale per la P.A.A. si potrebbe pensare ad una finestra per l’aggiornamento dei periodi con lo stesso timing dell’effetto. Ad esempio, se ho una serie con ciclicità mensile e voglio valutare i pattern su finestre settimanali potrei impostare:
- orizzonte di aggiornamento mensile
- finestra per il SAX Encoding settimanale
così da studiare SAX String di lunghezza 4 o 5.
Naturalmente con fenomeni fortemente erratici questo è più complicato da decidere, quasi sicuramente i risultati dei nostri modelli (anomaly detection, classificazione, clustering, …) varierebbero molto frequentemente.
Prendendo ad esempio il nostro dataset. Se ci fermassimo una settimana prima, nel grafico seguente i dati si fermano al 13 aprile, le sequenze non singleton sarebbero molte di più. Questo solo per rimarcare ancora una volta l’importanza della scelta dela giusta finestra temporale e del periodo di osservazione in relazione al fenomeno che si và ad analizzare.

Se volete approfondire questo tema vi consiglio il paper “A Symbolic Representation of Time Series, with Implications for
Streaming Algorithms” di Jessica Lin, Eamonn Keogh, Stefano Lonardi, Bill Chiu.


Overview
1.1 Definizione
1.2 Algoritmo
1.3 Window Constraint
1.4 Miglioramenti al DTW
Image Credits
Dynamic Time Warping
Definizione
Dynamic Time Warping (DTW) è un algoritmo utilizzato per misurare la similarità tra due o più serie temporali, andando a leggere su Wikipedia troviamo la seguente definizione:
Che casi d’uso ci suggerisce la definizione? Prendiamo ad esempio il riconoscimento vocale, una persona potrebbe parlare più velocemente o più lentamente della voce campione preregistrata, il DTW non risente di questo problema a differenza di una distanza che venga applicata “punto per punto”.
Il DTW è molto utilizzato in ambito IoT dove gli stream di dati proveninenti da video, audio, sensori, possono essere trasformati in una sequenza lineare per essere analizzati con questa tecnica, in particolare è molto efficace con serie ad alta frequenza di campionamento, pensiamo ad esempio al mercato delle utilities o dell’automotive.
L’idea di base è calcolare la distanza tra due vettori/serie storiche indipendentemente dalla loro lunghezza e per farlo bisogna che i vettori rispettino le seguenti regole:
Algoritmo
L’algoritmo di base è molto semplice, vedremo la differenza della similarità tra serie con DTW e distanza euclidea, partiamo creando gli array.
Le due serie hanno lunghezza diversa quindi un confronto punto per punto con distanza euclidea (o altra distanza) non sarebbe del tutto corretto. Supponiamo che le due serie partano nello stesso periodo e che la serie_2 finisca prima, quindi aggiungiamo un elemento per calcolare la distanza (non rispetta le regole sugli indici del DTW).
\[ d\left( p,q\right) = \sqrt {\sum _{i=1}^{n} \left( q_{i}-p_{i}\right)^2 } \]
La distanza calcolata è 7.14.
Passiamo ora al calcolo della distanza mediante DTW, per farlo ci servirà una matrice di dimensione n x m dove m ed n sono la lunghezza della serie più 1.
Il primo elemento della matrice DTW[0,0] deve essere pari a 0, mentre prima riga e prima colonna pari ad infinito. Quanto fatto serve per il cold start dell’algoritmo.
Il cold start è il confronto con i periodi precedenti quando si è al primo passo dell’algoritmo, impostando una riga fittizia ad infinito non si incorre in situazioni anomale e si evita di implementare condizioni sullo start che appesantirebbero ulteriormente il calcolo.
Per ogni posizione della matrice verrà calcolata la distanza euclidea di ogni punto di una serie da tutti i punti delle altre partendo dalla posizione DTW[1,1]. Ad ogni distanza viene aggiunto il minimo tra:
L’algoritmo restituisce una matrice con tutte le posizioni valorizzate.
Arrivati a questo punto partendo da DTW[0,0] bisogna costruire un percorso che tocchi il valore minimo più vicino a quello nella posizione in cui ci troviamo muovendoci da sinistra verso destra in orizzontale/verticale/obliquo, questo è il Warping Path.
Il valore finale del path è la distanza tra le serie.
Dalla matrice si nota che il calcolo non è stato influenzato dalla diversa dimensione delle sequenze e che il valore finale è molto più piccolo di quello calcolato punto per punto con la distanza euclidea.
Window Constraint
La complessità di calcolo del DTW è O(m * n) dove m e n rappresentano la lunghezza di ciascuna sequenza quindi se avessimo sequenze molto lunghe il confronto tra le due risulterebbe complesso, ed anche inutile, perchè alcuni confronti verrebbero effettuati su posizioni lontanissime.
Prendiamo l’esempio della serie storica, vorrebbe dire confrontare periodi molto distanti temporalmente che non hanno nessuna relazione ed influenza tra loro.
Per questo motivo viene inserita un parametro w, una finestra temporale su cui calcolare le differenze.
La finestra temporale è il valore minimo tra un intero definito dall’utente (io ho utilizzato 1) e la differenza in valore assoluto tra m ed n.
Di seguito come cambia l’algoritmo per il calcolo della distanza.
Nell’esempio proposto non si noteranno differenze viste le sequenze molto corte e con una differenza di una sola posizione, ma per sequenze molto lunghe e con differenze di lunghezza evidenti l’impatto è tangibile.
Miglioramenti al DTW
Vista la complessità quadratica del DTW sono stati proposti alcuni migliorameti dell’algoritmo, il più conosciuto è probabilmente il FastDTW.
Il FastDTW cerca di migliorare le performance approssimando alcuni risultati, non sempre questa riduzione di tempi si traduce in una qualità del risultato accettabile.
Ci sono molti paper e package su questo algoritmo, vi lascio il link della libreria python fastdtw e il paper “FastDTW is approximate and Generally Slower than the Algorithm it Approximates” che spiega in quali casi questo algoritmo sia davvero più performante (mantenendo accettabile l’efficacia) del DTW classico.
DTW e Machine Learning
Tornando a quanto detto nell’introduzione, come può essere/viene usato il DTW nei problemi di Machine Learning?
Di seguito un esempio di clustering basato sul DTW.
Ingrandendo il grafico finale si può notare come alcune serie dei cluster B e C sembrino molto più vicine al centroide A in alcuni periodi ma il DTW non ne risente e permette un raggruppamento migliore.
Lascio alcuni paper del 2020 sull’argomento per chi volesse approfondire: